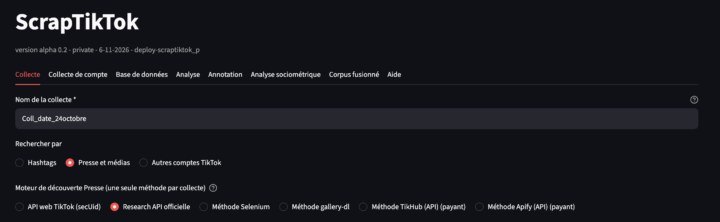
Initialement, j’avais commencé à travailler sur une interface graphique permettant de tester différentes méthodes de collecte des données sur TikTok : Selenium (qui simule la navigation d’un utilisateur), la gestion du secUid (pour contourner les erreurs HTTP 429 renvoyées par la plateforme, (fonctionne pas vraiment…)), ainsi que des solutions payantes comme TikHub (qui permet de récupérer la balise de texte généré par l’IA de TikTok) et Apify.
Puis… j’ai tenté ma chance avec un projet de recherche en sollicitant un mode de collecte officiellement reconnu par TikTok : l’API Research. Réservée aux chercheurs et universitaires, elle permet de collecter les métriques d’engagement (vues, likes, partages, favoris), les textes, les hashtags et les commentaires. L’accès à l’API Research nécessite de déposer une candidature sur le site TikTok for Developers en qualité de chercheur. La demande doit présenter un projet de recherche, comprenant des hypothèses, une note méthodologique et une bibliographie. L’autorisation obtenue permet d’extraire les données publiques via l’API officielle, dans la limite du quota accordé par TikTok : 1 000 requêtes par jour, ce qui est plutôt cool !

Qui dit API dit nécessité préalable, pour exploiter les données, de paramétrer les clés fournies par TikTok (client_key et client_secret). Personnellement, je les ai intégrées directement dans les variables d’environnement de l’application hébergée sur mon VPS. C’est la raison pour laquelle l’application est temporairement fermée.
1. Les champs disponibles dans l’API Research
1.1 Le champ texte
Prioritairement en analyse lexicométrique, ce champ nous intéresse et permet de récupérer la description rédigée par l’auteur et les hashtags. En revanche, TikTok ne propose pas de champ spécifique pour les descriptions générées par l’IA de TikTok. Il faudra donc recourir à une autre méthode, notamment Selenium, qui simule la navigation d’un utilisateur sur la plateforme. Cette opération ralentit la collecte et reste parfois aléatoire, TikTok pouvant demander la résolution d’un CAPTCHA. Il est toutefois possible de combiner les deux méthodes.
1.2 Le champ Voice to text
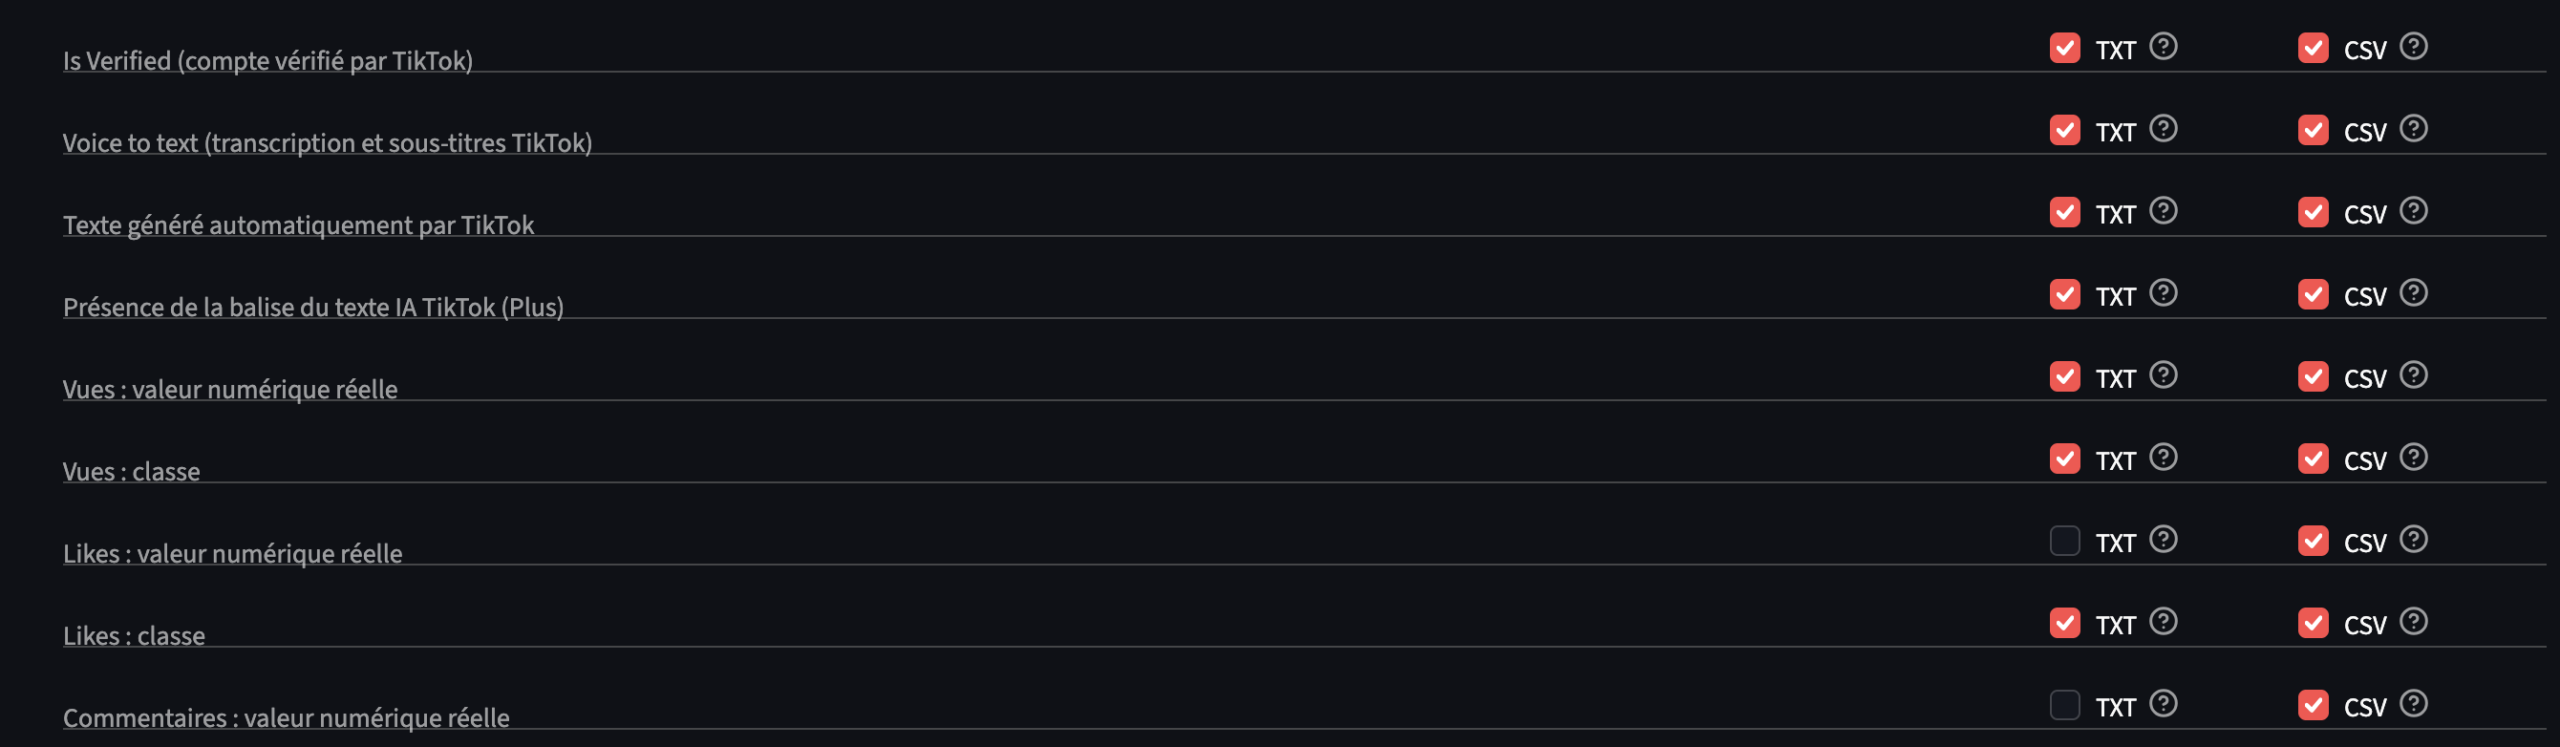
Aussi incroyable que cela puisse être, TikTok propose ce champ ! Il permet de récupérer, lorsqu’elle est disponible, la transcription de la parole ou les sous-titres de la vidéo. Ce champ nous épargne du temps, puisqu’il n’est pas nécessaire de passer par Whisper pour transcrire les contenus audio.
1.3 Le champ commentaire
Nous pouvons récupérer les commentaires et leurs réponses, et sur TikTok, autant dire qu’il y a de la “matière” !
Vous pourrez par exemple réaliser une analyse de co-commentaire des vidéos. Une nuance toutefois : TikTok ne fournit pas le nom du profil dans les commentaires (mais uniquement le nom déclaré), c’est donc une donnée “instable” au niveau de l’identification du profil.
1.4 Les métriques d’engagement
Like, vue, partage, favoris… au niveau des variables numériques vous aurez toutes les données que vous souhaitez ! Le script permet de reconstruire des variables catégorielles à partir de ces données brutes.
1.5 Le champ “is verified”
Ce champ false/true permet de récupérer si le compte a été vérifié et certifié par TikTok.
2. Stratégie de requête et contraintes méthodologiques
2.1 Des requêtes par compte et/ou des htag
En mode de collecte par htags, l’interface permet de sélectionner jusqu’à 30 htags simultanément. Pour affiner au maximum le ciblage du corpus, la requête s’appuie sur des combinaisons logiques en ET / OU, ainsi que sur l’opérateur NOT permettant d’exclure les htags non désirés.

2.2 Identification des comptes
L’API Research permet de cibler directement des profils (médias nationaux, presse régionale ou comptes individuels). Toutefois, identifier manuellement les comptes pertinents sur une thématique s’avère chronophage. Un module parallèle extrait automatiquement des profils en croisant des htags et une géolocalisation, afin d’alimenter directement la liste principale de collecte. Cette géolocalisation doit toutefois être recueillie manuellement en cliquant sur la localité apparaissant sous un post (ce qui n’est pas toujours le cas) — par exemple, l’identifiant de la ville de Toulouse : https://www.tiktok.com/place/Toulouse-22535796483363264
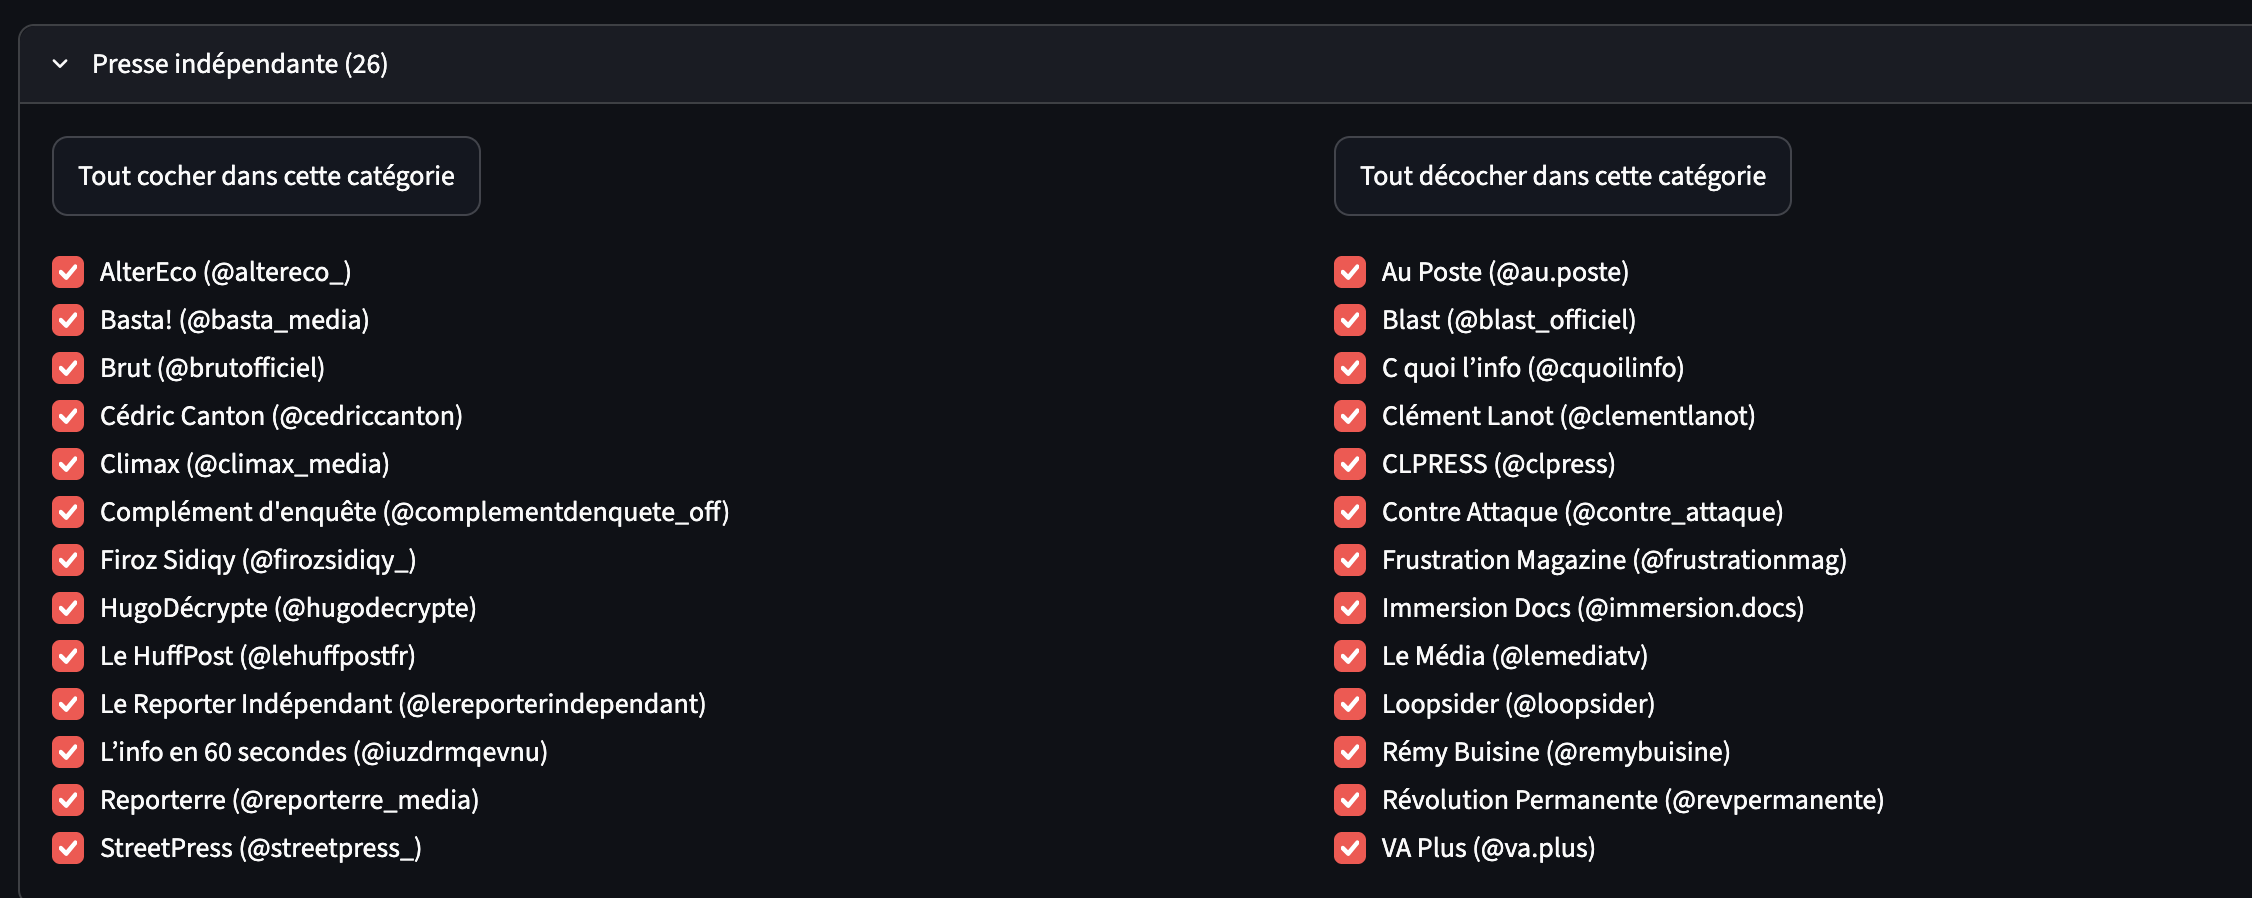
Cette sélection par compte soulève néanmoins un “biais méthodologique” : certains reporters, comme Rémy Buisine, diffusent une partie de leurs contenus sur les comptes de médias comme “Brut” plutôt que sur leur profil personnel. Cette dissociation entre production et diffusion peut introduire des biais dans la constitution du corpus.
Enfin, il convient également de rester vigilant quant aux limites de la Research API de TikTok, dont les omissions de vidéos publiques ont été documentées par AI Forensics (2025).
2.3 Sélection des périodes
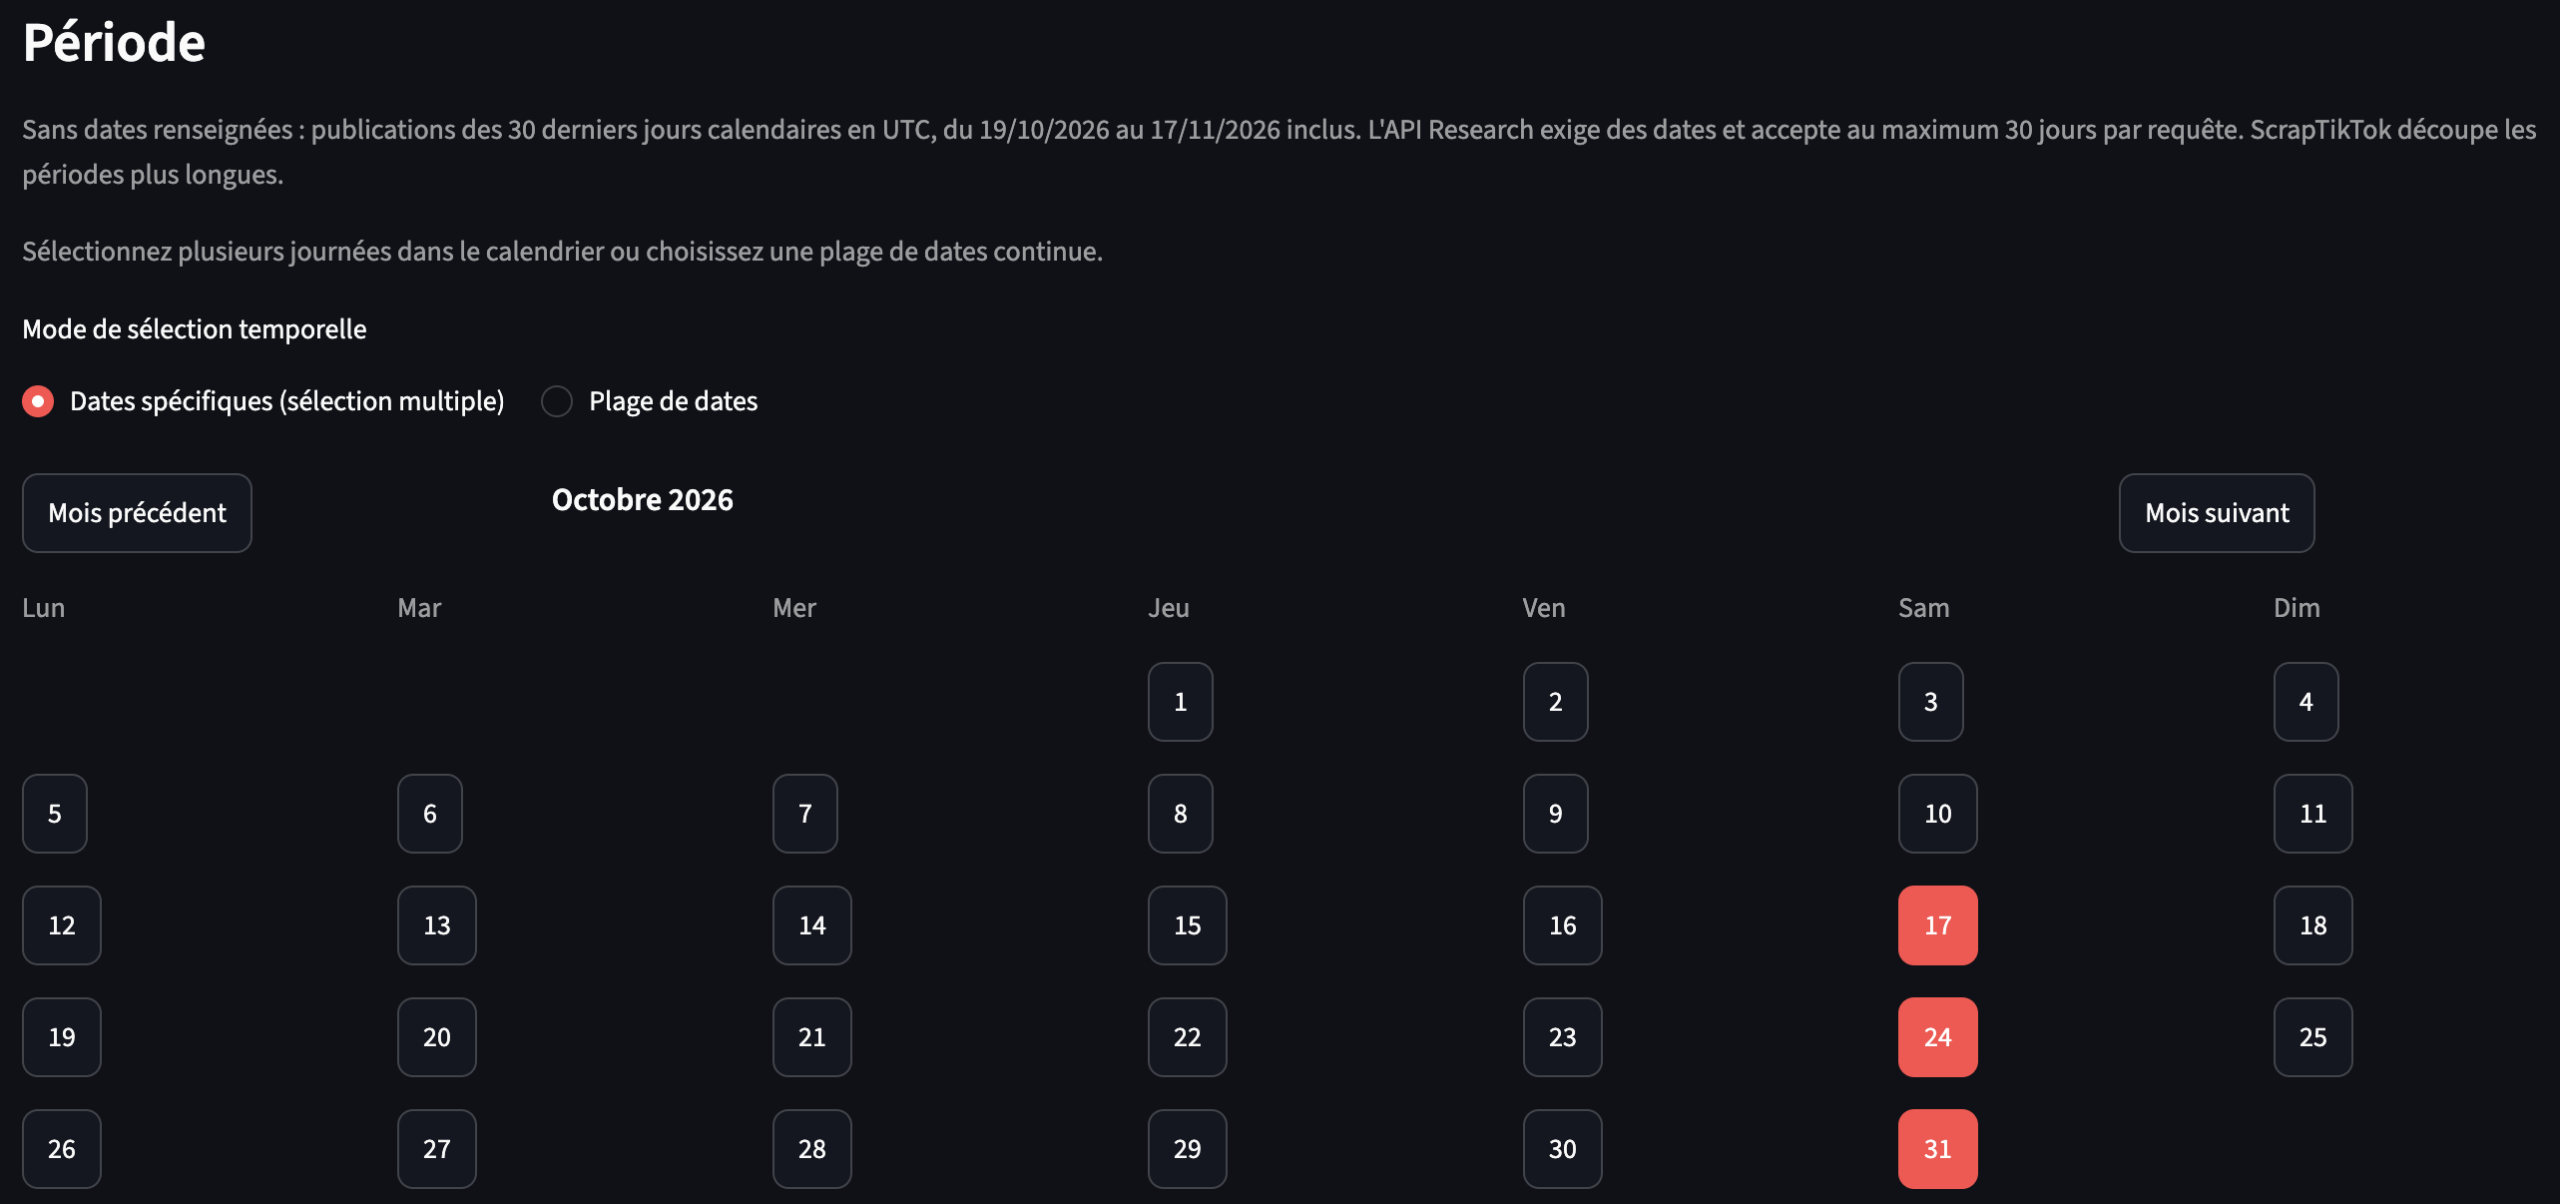
Le calendrier permet de définir une plage chronologique précise ou de sélectionner plusieurs dates discontinues (par exemple les 17, 24 et 31 octobre…). Si aucune date n’est spécifiée, TikTok applique par défaut une collecte sur les 30 derniers jours.
2.4 Pagination
L’accès à l’API Research est soumis à un quota de 1 000 requêtes par jour. Si une collecte s’étend sur un grand volume de données, elle risque donc d’être interrompue et de rester incomplète. Pour pallier cette contrainte, le script s’appuie sur un historique de collecte capable de mémoriser la dernière page consultée pour chaque compte et de reprendre l’extraction sans repartir de zéro.
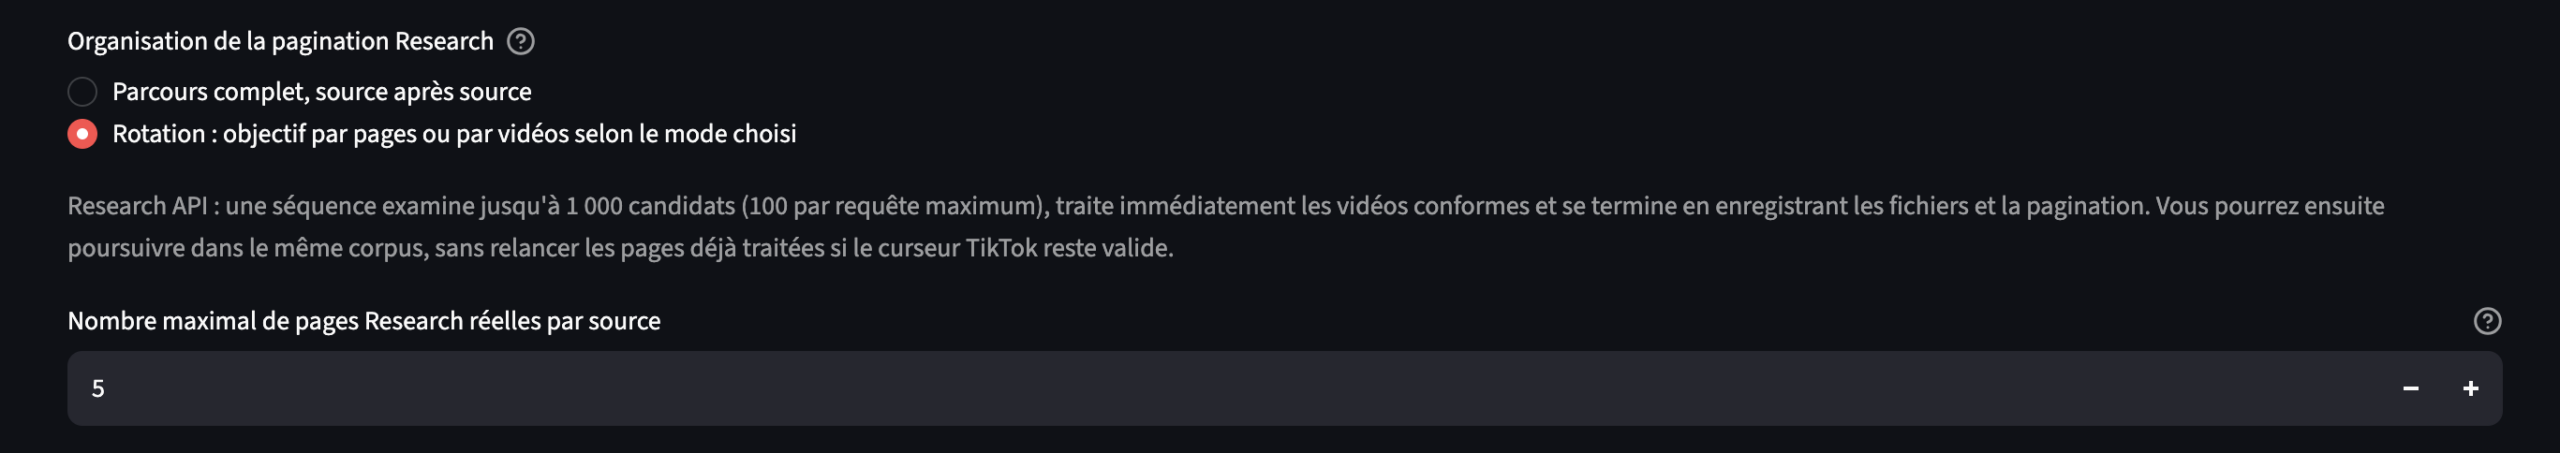
Il est également possible de paramétrer des limites, notamment un nombre maximal de pages ou de vidéos à collecter par profil. Afin d’homogénéiser l’exploration entre les différents médias, la collecte repose sur une rotation successive (tour par tour) : si l’on fixe par exemple une limite de 5 pages par compte, le script interroge la page 1 de tous les profils de la liste, puis boucle sur la page 2 de chacun d’eux, et ainsi de suite. Une autre option permet de définir un quota brut de vidéos à atteindre par média, le script adaptant alors automatiquement la pagination.
3. Zoom sur le texte généré par IA
TikTok a expérimenté en 2026 un dispositif nommé “AI Overviews”, qui génère automatiquement des descriptions textuelles destinées à contextualiser certaines vidéos.

Contrairement à la légende rédigée par l’auteur, ce texte est produit par un système algorithmique de la plateforme, sans intervention explicite du créateur. Aucune fonction permettant à l’auteur de déclencher, modifier ou valider ces résumés n’est publiquement documentée. Le dispositif n’est pas présent systématiquement sur toutes les vidéos.
En mai 2026, TikTok a annoncé avoir restreint cette fonctionnalité expérimentale après la production de descriptions erronées liées à des hallucinations du modèle.
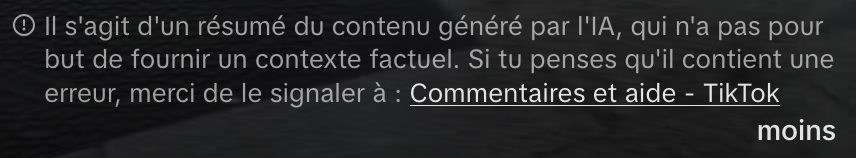
Immédiatement, cette balise fait écho à la notion de cadrage (Goffman, 1974 ; Entman, 1993), mais qui mérite une nuance : ce cadrage est réalisé par un algorithme dénué de conscience et de rapport au monde. Sa nouveauté réside dans son caractère automatisé : le texte produit ne découle pas d’une intentionnalité de l’auteur (qu’il soit journaliste ou simple usager), mais d’un calcul probabiliste et de règles d’alignement fixées par le modèle et ses ingénieurs (Alombert, 2023).
Bien que l’approche sociologique du cadrage possède l’avantage d’ancrer la construction des discours dans les dynamiques des divers acteurs de l’espace public, elle ne permet pas de comprendre le processus de traitement de l’information qui survient chez le spectateur (Lemarier-Saulnier, 2016).
4. Exemple de collecte : du terrain à la problématique
#17octobre, #24octobre #31octobre, #blocus et #violences.Le corpus cible est composé de 21 comptes associant médias nationaux et presse indépendante pour un total de 677 vidéos collectées.
Certaines publications présentent ainsi deux modalités textuelles distinctes : la légende rédigée par l’auteur et la description générée par l’intelligence artificielle de TikTok.
Une analyse lexicométrique exploratoire à partir d’une CHD a permis ensuite de se concentrer sur la distribution du terme “violence” au sein des classes. Le terme totalise 705 occurrences sur l’ensemble du corpus (93 287 mots). Il apparaît 418 fois dans les descriptions algorithmiques (modalité ia), contre 478,56 occurrences attendues, et 287 fois dans les légendes des auteurs (modalité original), contre 226,44 attendues.
Le sous-corpus IA représente environ 67,9 % du volume lexical total (63 324 mots) contre 32,1 % pour les textes des auteurs (29 963 mots), ce qui rend les résumés générés par la plateforme environ 2,11 fois plus volumineux que les textes originaux. Pourtant, malgré cette masse textuelle nettement supérieure, l’IA emploie proportionnellement moins le terme “violence”.
L’analyse de spécificité lexicale (loi hypergéométrique – Lafon, 1980) confirme une sous-représentation statistiquement significative du terme dans la modalité IA (score = -6,0408 avec p ≤ 0,01) et une surreprésentation symétrique chez les auteurs (score = +6,0408).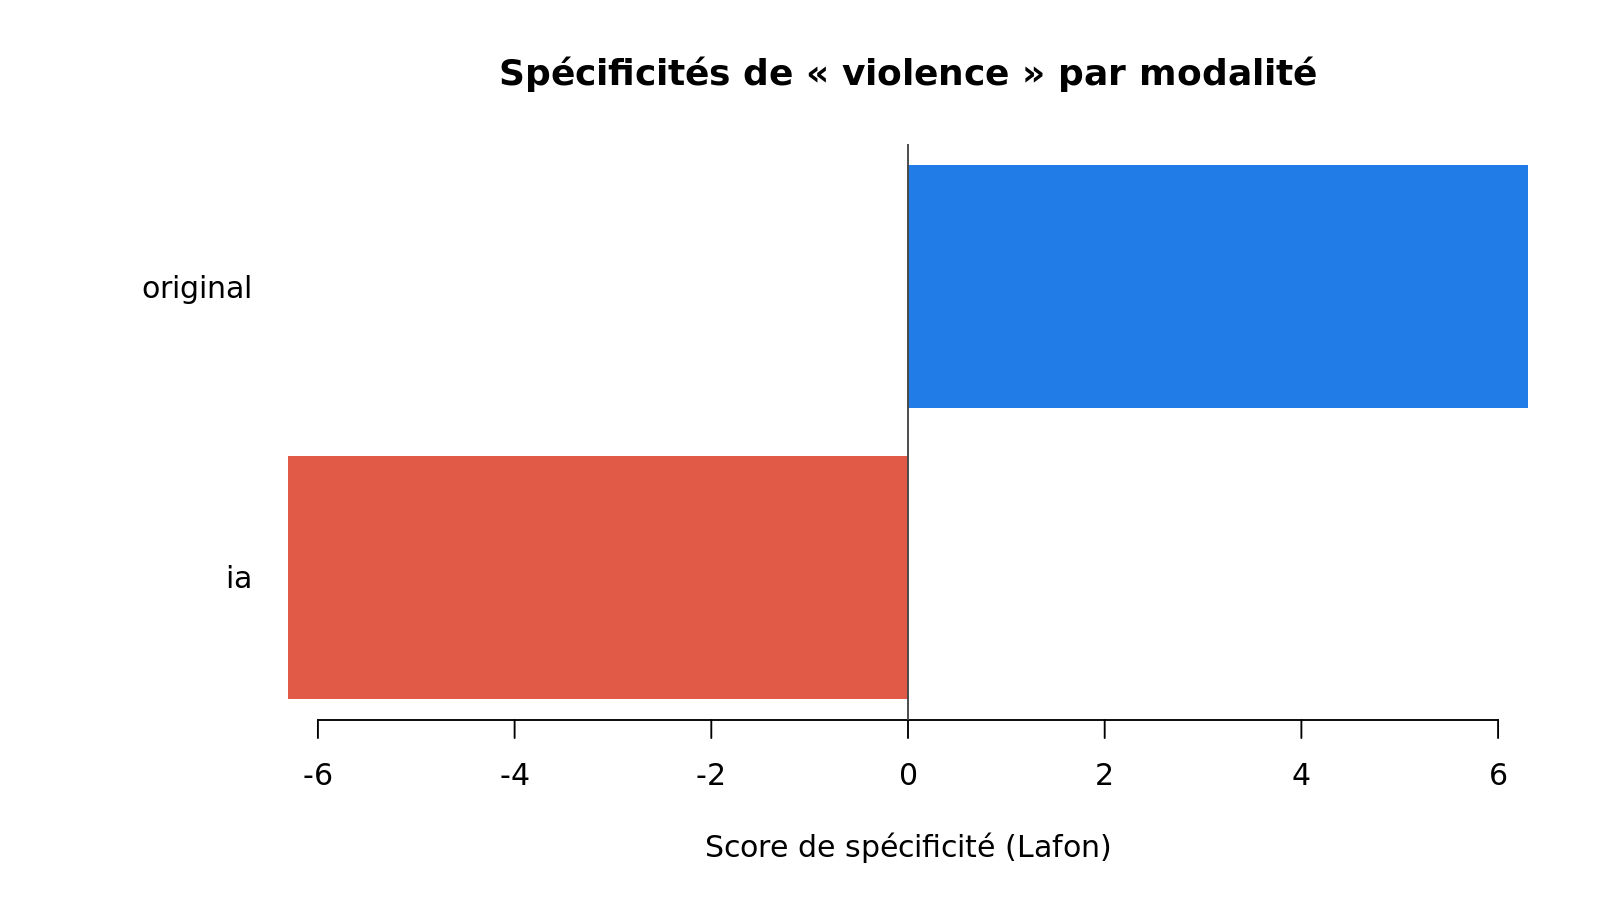 Ce résultat descriptif met en évidence un décalage “d’orientation” entre les deux textes. Aussi surprenant que cela puisse paraître, la publication d’un auteur se voit étayée d’un résumé algorithmique à son insu, qui modifie le cadrage initial de l’événement. Alors que le Web s’est fondé sur un principe d’ouverture et de liberté d’expression porté par son inventeur (Tim Berners-Lee) et sur la figure de l'”auteur du Web”, l’intrusion d’un résumé algorithmique généré par la plateforme vient altérer cette autonomie éditoriale.
Il convient donc de distinguer désormais quatre niveaux de circulation de l’information au sein d’une publication TikTok : le son, l’image, le texte de l’auteur et le texte généré par l’IA, qui reconfigurent la mise en spectacle et la qualification de la souffrance à distance (Boltanski, 1993).
Dès lors, cette intuition émergente peut se transformer en questionnement scientifique : dans quelle mesure la production algorithmique d’un discours participe-t-elle à la transformation des représentations sociales des manifestations lycéennes, et plus particulièrement des phénomènes de violence ?
L’apparition de ces résumés automatisés introduit un “cadre algorithmique”, un discours “prescrit” par la plateforme qui s’intercale entre l’auteur et son public. Ce dispositif peut être interrogé comme une forme de violence symbolique et de domination (Bourdieu, 1982) particulièrement paradoxale : alors même que les publications traitent de la violence lors des manifestations, l’IA exerce sa propre violence (symbolique) en imposant sa norme discursive. En se présentant comme une “simple supplémentation de texte descriptive”, concept qui émerge dans la démarche de déconstruction de Derrida (De la grammatologie, 1967), ce texte automatisé pourrait venir concurrencer, voire supplanter, le cadrage initial de l’auteur.
Toutefois, en s’inscrivant dans la lignée des travaux d’André Gunthert (2014, 2020) sur l’image conversationnelle, la publication numérique ne s’arrête pas à ce discours prescrit : elle constitue un espace d’échanges où le sens reste constamment négocié par les usagers.
Une hypothèse poserait alors que la production textuelle algorithmique transforme la “saillance” des catégories discursives (Moliner, 1996 ; Guimelli, 1994) mobilisées pour qualifier les faits, sous-représentant le terme “violence”. C’est précisément dans l’espace conversationnel des commentaires que l’on pourrait observer la portée de ce recadrage : les usagers s’approprient-ils les catégories “lissées” par l’IA, ou manifestent-ils une résistance aux cadrages imposés par la plateforme ?
Conclusion
Cette analyse exploratoire montre l’intérêt d’articuler ingénierie des données, dispositif sociotechnique (l’IA) et “sociologie des médias”.
L’enjeu réside dans le croisement lexicométrique des quatre modalités textuelles de notre corpus : les légendes des auteurs, les transcriptions audio (voice-to-text), les descriptions IA et les commentaires des usagers. Il s’agit d’analyser comment s’articulent la prescription d’un cadre par la plateforme, sa circulation dans la publication et son éventuelle appropriation par les usagers. Ainsi, il convient de se demander dans quelles conditions ce cadrage algorithmique peut-il être réapproprié dans les échanges et participer à la transformation des représentations sociales (Moscovici, 1961 ; Jodelet, 1989 ; Doise, 1992 ; Abric, 1994 ; Moliner, 1996) ?
Références bibliographiques
Alombert, A. (2023). Schizophrénie numérique. Paris : Allia
Boltanski, L. (1993). La souffrance à distance. Morale humanitaire, médias et politique. Paris : Métailié.
Cardon, D. (1994). La souffrance à distance (Luc Boltanski). Réseaux, 12, 123-126.
Entman, R. M. (1993). Framing: Toward Clarification of a Fractured Paradigm. Journal of Communication, 43, 51–58.
Goffman, E. (1991). Les Cadres de l’expérience. Paris : Éditions de Minuit.
Gunthert, A. (2014). L’image conversationnelle. Les nouveaux usages de la photographie numérique. Études photographiques, 31, 54-71.
Gunthert, A. (2020). L’image virale comme preuve. Les vidéos des violences policières dans la crise des Gilets jaunes. Communications, 106, 187-207.
Lemarier-Saulnier, C. (2016). Cadrer les définitions du cadrage : une recension multidisciplinaire des approches du cadrage médiatique. Revue canadienne de communication, 41, 65–84.
Moscovici, S. (1961). La psychanalyse, son image et son public. Paris : Presses universitaires de France.


